작업 기록에는 수집 완료라고 남아 있는데, 막상 글이나 보고서의 근거를 찾으려 하면 자료를 열 수 없는 순간이 있습니다. 저도 자료 목록과 식별자를 갖춘 수집 작업을 다시 꺼냈다가, 사람이 바로 읽을 원문이 따로 준비돼 있지 않다는 사실을 확인했습니다.
AI에게 넘길 자료가 많아 보인다고 해서 바로 요약을 시작하면 안 된다는 판단은 그때 생겼습니다.
그 작업에는 제목과 식별자가 남아 있었고, 시스템 기록도 저장이 끝났다고 말하고 있었습니다. 그러나 실제 근거로 쓰려 몇 건을 열어 보니 본문 대신 브라우저 응답이나 구조화 데이터만 남은 자료가 있었습니다. 제목은 검색됐지만, 사람이 처음부터 끝까지 읽으며 맥락을 확인할 문서는 바로 나오지 않았습니다.
수집기는 저장을 마쳤습니다. 그 기록은 저장 여부를 뜻했습니다. 제가 필요로 한 완료 상태는 다음 사람이 원문을 열고 어떤 문장에서 나온 판단인지 확인할 수 있는 상태였습니다.
이 차이를 구분하지 않으면 자료 목록은 늘어나도 실제 업무는 다시 사람의 기억과 수작업으로 돌아갑니다. 특히 보고서, 콘텐츠, 회의 정리처럼 근거를 다시 꺼내야 하는 일에서는 더 그렇습니다.
읽을 수 있는 원문이 없는 상태에서도 AI는 요약문을 만들 수 있습니다. 문장이 자연스럽게 나오면 작업이 끝난 것처럼 보이기도 합니다. 하지만 나중에 한 문장을 확인하려 할 때, 그 문장이 어느 자료의 어느 부분에서 왔는지 찾을 수 없다면 결과를 검수하기 어렵습니다.
그래서 저는 원시 자료와 사람이 읽는 문서를 같은 것으로 취급하지 않기로 했습니다. 원시 자료는 보존하고, 읽는 문서는 제목·본문·출처가 이어진 형태로 따로 만들었습니다. 그 뒤에만 요약이나 분석 결과가 가리키는 원문을 확인할 수 있었습니다.
이 과정은 사람이 다시 확인할 수 있는 출발점을 남깁니다. 답의 정확성은 별도 검토가 필요합니다. 원문이 없는 요약은 빠를 수 있어도, 검수와 수정이 필요한 순간에는 다시 일을 시작하게 만듭니다.
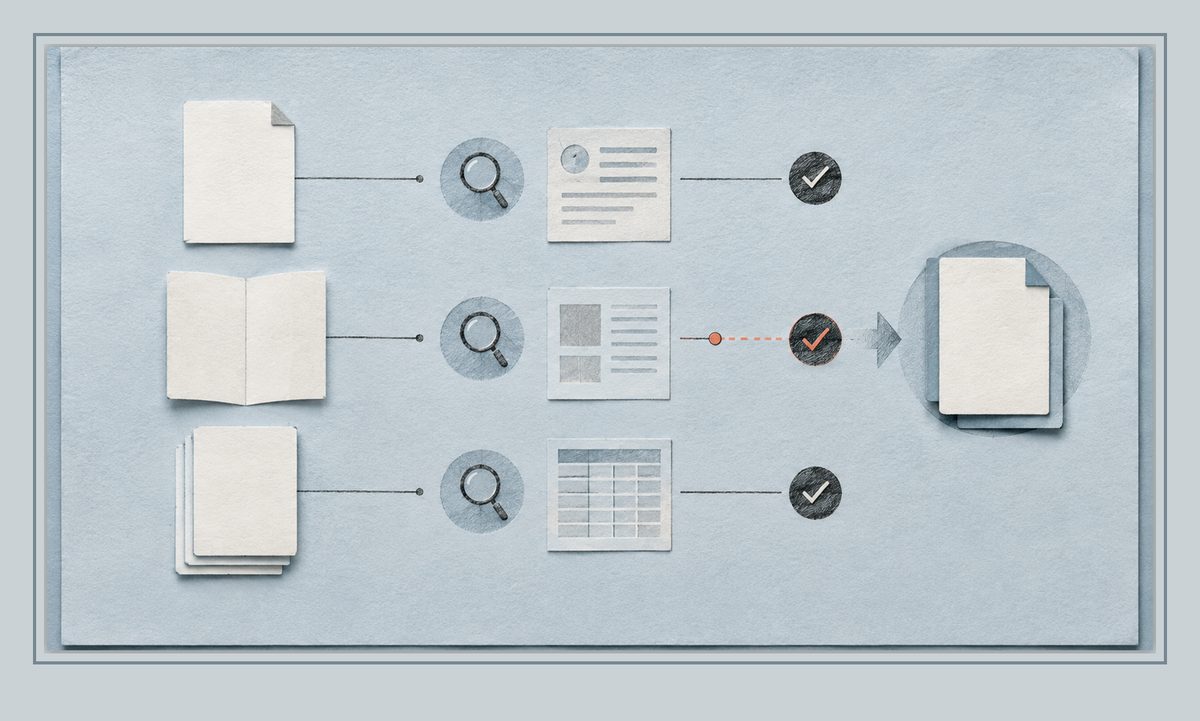
문서가 많은 조직이라면 전체를 정리하기 전에 자료 세 개만 골라 아래를 확인해 볼 수 있습니다.
셋 중 하나라도 막히면 자료 복구와 연결부터 진행합니다. 요약은 그 다음입니다. 원시 자료의 위치, 사람이 읽는 문서의 위치, 처리 상태를 한 줄로 연결해 두면 다음 단계에서 무엇을 다시 실행해야 할지도 보입니다.
이 작은 점검만으로 모든 자료의 사실성을 보장할 수는 없습니다. 다만 AI 요약이나 검색형 도입을 시작하기 전에, 검수 가능한 자료와 아직 정리해야 할 자료를 구분할 수 있습니다.
AI를 도입하려는데 문서와 기록은 이미 많은 조직이라면, 먼저 자료가 실제로 읽히는지와 결과가 원문으로 돌아갈 수 있는지를 함께 진단할 수 있습니다. 업무 진단, 자료 상태 분류, 검수 지점 설계, 워크플로와 도입 교육의 범위를 실제 업무 하나에서 정리합니다.
💬 카카오톡 오픈채팅으로 AI/AX 컨설팅 문의하기: https://open.kakao.com/o/gWlTq9Ai
👤 류웅수 프로필 보기: https://sia-ian.vercel.app/
실제 자료 수집 작업에서 원문 복구와 해시 대조를 진행한 기록을 바탕으로 썼습니다. 내부 자료 수량, 경로, 출처 플랫폼, 고객 정보는 공개하지 않았습니다.